Single Point of Failure چیست و چرا خطرناک است؟
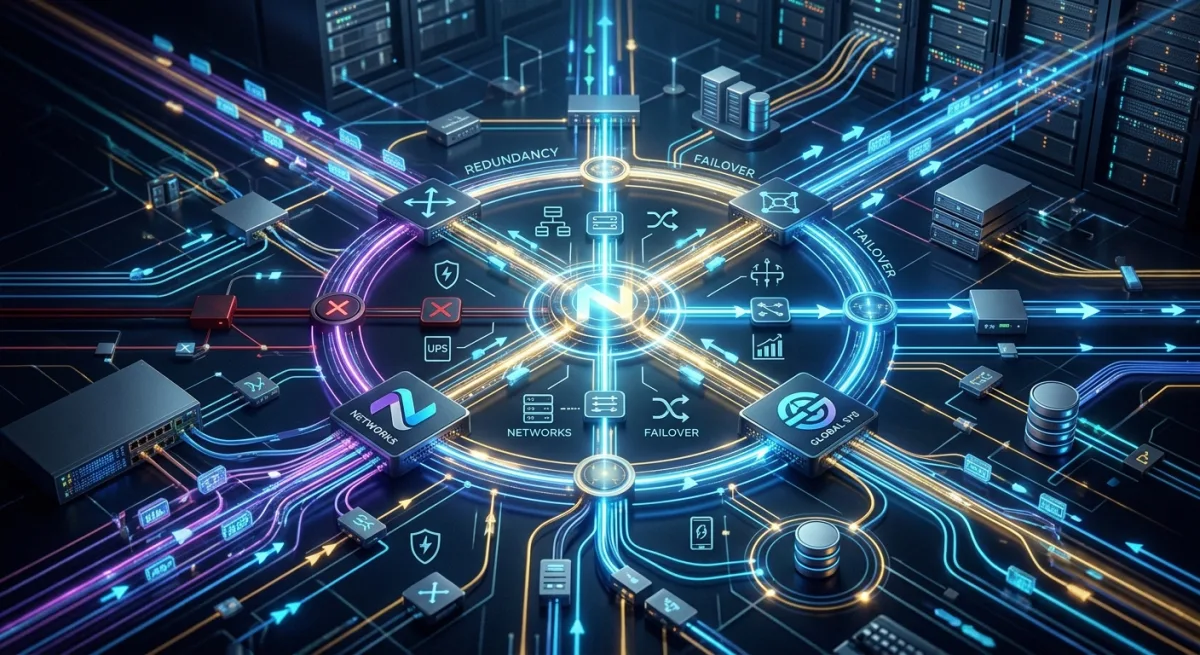
هر جزئی از شبکه که اگر خراب شود کل سیستم از کار بیفتد، Single Point of Failure (SPOF) نام دارد. در یک شبکه بدون Redundancy، خرابی یک سوئیچ، یک کابل یا یک روتر میتواند کل سازمان را فلج کند.
لایههای Redundancy
Redundancy کابل
هر لینک مهم باید یک مسیر backup داشته باشد. بین سوئیچ Core و Distribution حداقل دو لینک موازی (Link Aggregation یا دو مسیر مستقل) داشته باشید.
Redundancy سوئیچ
Spanning Tree Protocol (STP) یا نسخه سریعتر آن RSTP از Loop جلوگیری میکند در حالی که مسیرهای backup آماده هستند. برای محیطهای حساس MSTP توصیه میشود.
Redundancy Gateway
پروتکلهایی مثل HSRP (Cisco) یا VRRP (استاندارد) دو روتر را به صورت Active/Standby مدیریت میکنند. اگر روتر اصلی خراب شد، روتر دوم در کمتر از یک ثانیه جای آن را میگیرد.
Redundancy اتصال اینترنت
دو لینک از دو ISP مختلف داشته باشید. اگر یکی قطع شد، ترافیک به دیگری منتقل میشود.
Redundancy برق
UPS و ژنراتور برای تجهیزات شبکه ضروری است. بسیاری از خرابیهای «شبکه» در واقع خرابی برق هستند.
هزینه در برابر سطح Redundancy
Redundancy کامل هزینه دارد. باید بر اساس اهمیت کسبوکار تصمیم گرفت:
خطوط تولید، بانک، بیمارستان: Redundancy کامل — هزینهاش به خرابی یک ساعت نمیرسد
دفاتر اداری: Redundancy در لایه Core، ساده در لایه Access
کسبوکارهای کوچک: حداقل Redundancy اینترنت و UPS
جمعبندی
طراحی Redundancy باید از همان ابتدای پروژه در نظر گرفته شود — اضافه کردن آن به یک شبکه موجود بسیار سختتر و گرانتر است. پایدار سپهر در طراحی شبکههای High Availability برای محیطهای حساس تجربه عملی دارد.